8 min czytania
Jev vs. LLM: jak dobrać model do automatyzacji AI
Automatyzacja AI jest często przedstawiana jako jeden duży model obsługujący cały proces. W praktyce bardziej użyteczne systemy składają się zwykle z wielu mniejszych decyzji i działań: klasyfikacji danych wejściowych, wyboru ścieżki, pobrania informacji, wygenerowania odpowiedzi, jej walidacji oraz decyzji, czy potrzebna jest interwencja człowieka.
Prowadzi to do praktycznego pytania: czy każdy krok rzeczywiście wymaga generatywnego dużego modelu językowego?
W zadaniach otwartych, wymagających rozumowania lub tworzenia treści, LLM może być właściwym narzędziem. Przy wąskiej i często powtarzanej decyzji, której możliwe wyniki są z góry znane, jego możliwości mogą być większe niż potrzeby procesu. Efektem bywa niepotrzebny koszt, dodatkowe opóźnienie oraz workflow, którego zachowanie trudniej przewidzieć.
Jev to nowy model zaprojektowany z myślą o takim węższym problemie. Zamiast generować tekst, przekształca nieustrukturyzowane dane wejściowe w ustrukturyzowane decyzje wraz z prawdopodobieństwami. W tym artykule wyjaśniamy, gdzie takie podejście ma sens, czym różni się od generatywnego LLM-a oraz jak oceniać je na tle rozwiązań lokalnych i open source.
Czym jest Jev?
Jev jest pierwszym publicznym modelem „System One” firmy TypeSafe AI. Użytkownik przekazuje stan oraz zdefiniowane wcześniej pytania, a model zwraca ustrukturyzowane odpowiedzi zamiast otwartego tekstu.
W praktyce wynikiem może być:
- wybór z określonego zbioru, na przykład
billing,technicallubother; - ocena na ustalonej skali;
- prawdopodobieństwo, że wskazany warunek jest spełniony.
Oficjalny TypeScript SDK pokazuje podstawowy wzorzec: model otrzymuje nieustrukturyzowany kontekst, a zwraca typowany wybór i rozkład prawdopodobieństwa. Dzięki temu Jev może znaleźć zastosowanie w klasyfikacji, routingu, ocenie warunków oraz wyborze kolejnego kroku procesu.
To rozróżnienie jest ważne. Poprawna struktura odpowiedzi ułatwia jej wykorzystanie przez oprogramowanie, ale zgodność typów nie gwarantuje poprawności samej decyzji. Jakość decyzji nadal trzeba mierzyć na danych reprezentatywnych dla konkretnej organizacji.
Jev a generatywny LLM
Jev i generatywne LLM-y nie są wzajemnie wykluczającymi się rozwiązaniami. Mogą obsługiwać różne części tego samego procesu.
| Obszar | Jev | Generatywny LLM |
|---|---|---|
| Wynik | Zdefiniowany wybór, ocena lub prawdopodobieństwo | Tekst, kod albo inny wygenerowany materiał |
| Najlepsze zastosowanie | Wąskie, powtarzalne decyzje ze znanym zbiorem wyników | Zadania otwarte, tworzenie treści i złożone rozumowanie |
| Integracja | Typowany wynik można bezpośrednio połączyć z logiką procesu | Wynik może wymagać schematu, walidacji i dodatkowych zabezpieczeń |
| Koszt i opóźnienie | Model projektowany do krótkich, częstych decyzji | Zależą od modelu, promptu, rozumowania i długości odpowiedzi |
| Niepewność | Prawdopodobieństwa mogą sterować progami i eskalacją | Sposób obsługi pewności trzeba zwykle zaprojektować osobno |
Praktyczna architektura często przypomina kaskadę. Model decyzyjny obsługuje częste, dobrze ograniczone przypadki. Generatywny LLM otrzymuje zadania, które rzeczywiście wymagają tworzenia treści lub szerszej interpretacji. Przypadki niejednoznaczne albo obarczone wysokim ryzykiem trafiają do modelu lokalnego lub człowieka.
To ta sama zasada, którą opisujemy w kontekście architektury enterprise AI: najpierw rozbijamy proces na decyzje, a dopiero później dobieramy odpowiednie narzędzie do każdej z nich.
Przykład: pre-check danych osobowych (PII) przed użyciem chmurowego LLM-a
PII to skrót od personally identifiable information, czyli informacji umożliwiających bezpośrednią lub pośrednią identyfikację osoby. Zależnie od kontekstu mogą to być między innymi imię i nazwisko, adres e-mail, numer rachunku, lokalizacja, identyfikator internetowy lub inne informacje powiązane z konkretną osobą.
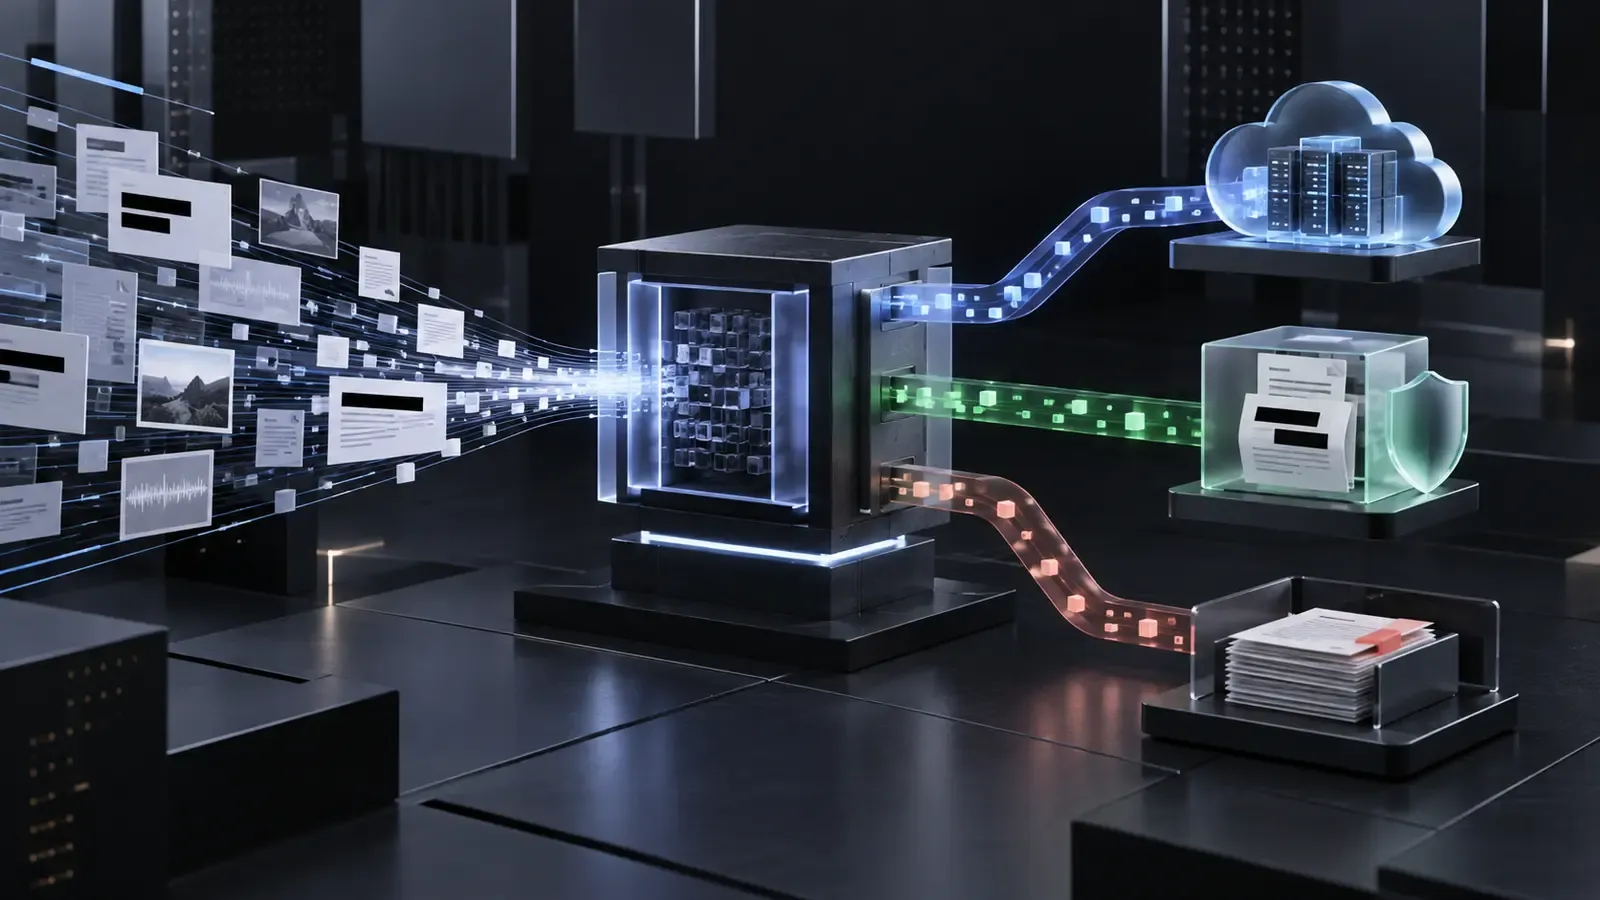
Załóżmy, że organizacja chce przekazywać zapytania klientów do chmurowego LLM-a. Treść może zawierać PII, informacje zdrowotne albo inne dane wrażliwe. Przed wywołaniem usługi chmurowej proces musi zdecydować, co powinno wydarzyć się dalej.
Prosta warstwa decyzyjna może zwracać jeden z trzech wyników:
safe_to_send: przekazanie treści do chmurowego LLM-a;pii_detected: zanonimizowanie lub zredagowanie odpowiednich danych przed wysłaniem;uncertain: skierowanie treści do modelu lokalnego albo weryfikacji przez człowieka.
Proces przyjmuje wtedy następującą postać:
Dane klienta → pre-check PII → wysłanie / anonimizacja / weryfikacja → chmurowy LLM
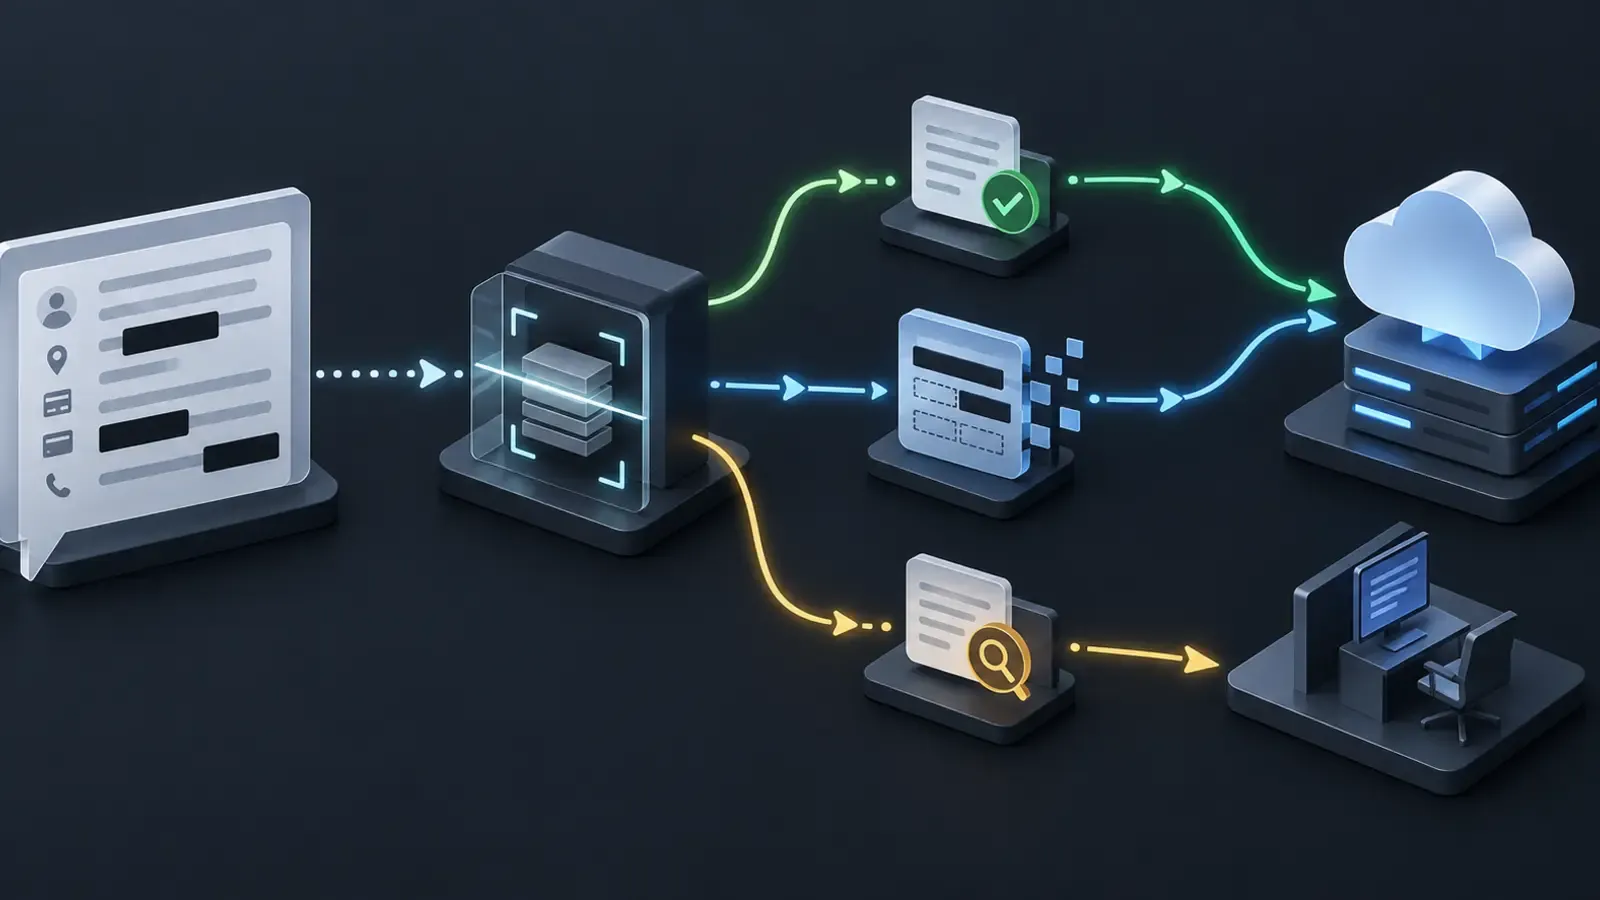
Jest to zadanie decyzyjne, a nie generatywne. Workflow nie potrzebuje akapitu opisującego treść zapytania. Potrzebuje ograniczonego zbioru wyników, na podstawie których kod wybierze następne działanie.
Jev może być jedną z implementacji tej warstwy, ponieważ przyjmuje nieustrukturyzowany stan i zwraca ograniczone odpowiedzi wraz z prawdopodobieństwami. Zespół może zdefiniować wybór pomiędzy trzema ścieżkami, a następnie wykorzystać rozkład prawdopodobieństwa i ustalony próg do określenia, czy dany przypadek powinien być obsłużony automatycznie.
Wykorzystanie zewnętrznej usługi do przeprowadzenia pre-checku rodzi jednak ważne pytanie architektoniczne: oryginalna treść musi trafić do tej usługi, zanim zostanie sklasyfikowana. Jeśli dane nie mogą opuszczać kontrolowanego środowiska organizacji, chmurowy pre-check nie jest właściwym pierwszym krokiem.
Progi pewności i eskalacja
Prawdopodobieństwo nie jest gwarancją. Stanowi dane wejściowe dla polityki procesu.
Załóżmy, że klasyfikator zwraca safe_to_send z prawdopodobieństwem 0,61. Wynik ma prawidłową strukturę, ale różnica może być zbyt mała, aby pozwolić na automatyczne wysłanie danych. System powinien mieć możliwość rezygnacji z najszybszej ścieżki.
Praktyczna polityka może łączyć:
- wysoki próg dla automatycznego routingu do chmury;
- niższy próg uruchamiający anonimizację;
- jednoznaczny zakres niepewności kierujący do przetwarzania lokalnego lub human review;
- surowsze reguły dla kanałów i kategorii danych o podwyższonym ryzyku;
- logowanie i monitoring umożliwiające analizę błędów fałszywie dodatnich i fałszywie ujemnych.
Progi należy dobierać na podstawie wyników ewaluacji, nie intuicji. System powinien być testowany na danych odzwierciedlających języki, typy dokumentów, skróty, formatowanie i identyfikatory branżowe używane w organizacji. Trzeba mierzyć zarówno niewykryte dane wrażliwe, jak i niepotrzebnie zablokowane treści, ponieważ oba błędy generują inne koszty.
Właściwy próg może także zależeć od kontekstu. Publiczne pytanie o produkt i zgłoszenie zawierające informacje medyczne nie powinny automatycznie podlegać tej samej tolerancji ryzyka.
Czego pre-check PII nie może zagwarantować
Pre-check jest jedną z warstw szerszego systemu ochrony danych. Sam w sobie nie stanowi dowodu bezpieczeństwa, prywatności ani zgodności regulacyjnej.
Każdy automatyczny detektor może generować:
- false negatives, czyli przepuszczać niewykryte informacje wrażliwe;
- false positives, czyli blokować lub anonimizować treści, które nie zawierają danych wrażliwych;
- niespójne wyniki dla nowych języków, formatów i identyfikatorów specyficznych dla organizacji.
Projekt produkcyjny może również wymagać minimalizacji danych, kontroli dostępu, zasad retencji, szyfrowania, logów audytowych, oceny dostawców i transferów danych, mechanizmów DLP, obsługi incydentów oraz konsultacji prawnej. Dokładny zestaw zabezpieczeń zależy od danych, jurysdykcji i kontekstu umownego.
Lokalne alternatywy i rozwiązania open source
Gdy dane muszą pozostać w infrastrukturze organizacji, warstwę decyzyjną można uruchomić lokalnie. Właściwy wybór zależy od tego, czy zadanie jest ścisłe, semantyczne czy generatywne.
Reguły, wyrażenia regularne i słowniki
Reguły są dobrym pierwszym wyborem dla stabilnych, dobrze zdefiniowanych wzorców, takich jak numery dokumentów, rachunków czy wewnętrzne identyfikatory. Są tanie, deterministyczne i łatwe do audytowania.
Ich słabą stroną jest kontekst. Liczba może pasować do formatu identyfikatora, mimo że nim nie jest, natomiast nazwiska i swobodnie zapisane informacje wrażliwe często nie mają stabilnej struktury.
Małe lokalne modele klasyfikacyjne
Kompaktowy klasyfikator tekstu może działać lokalnie i zwracać etykietę z określonego zbioru. Można dostroić go na przykładach organizacji albo wykorzystać klasyfikację zero-shot, gdy ilość oznaczonych danych jest ograniczona.
Takie rozwiązanie zapewnia większą kontrolę nad danymi i wdrożeniem, ale przenosi na organizację odpowiedzialność za wybór modelu, infrastrukturę inferencji, ewaluację, aktualizacje i monitoring.
Lokalne lub otwarte LLM-y
Lokalny LLM może zostać skonfigurowany tak, aby zwracał ustrukturyzowaną decyzję i interpretował bardziej złożony kontekst lub nietypowe przypadki. Jest użyteczny, gdy granica pomiędzy klasyfikacją a interpretacją nie jest jednoznaczna.
Kosztem jest większe zapotrzebowanie na zasoby i bardziej złożone utrzymanie. Nasze porównanie lekkich LLM-ów do lokalnego wdrożenia pokazuje, dlaczego rozmiar, szybkość i skuteczność w konkretnym zadaniu należy testować łącznie, zamiast zakładać je na podstawie ogólnego benchmarku.
Rozwiązania hybrydowe
W procesach operujących na danych wrażliwych dobrze sprawdza się architektura warstwowa:
- Reguły deterministyczne wykrywają identyfikatory o stabilnym formacie.
- Lokalny detektor PII lub model NER analizuje dane kontekstowe.
- Niejednoznaczne przypadki trafiają do modelu decyzyjnego albo lokalnego LLM-a.
- Przypadki wysokiego ryzyka lub o niskiej pewności są eskalowane do człowieka.
Takie podejście nie eliminuje błędów. Sprawia natomiast, że potencjalne tryby awarii są bardziej widoczne, a proces zyskuje kilka punktów, w których można zatrzymać lub skorygować ryzykowne działanie.
Jak dobrać narzędzie do decyzji
Wybierz Jev, gdy dane wejściowe są nieustrukturyzowane, zbiór odpowiedzi jest znany, decyzja często się powtarza, a przesłanie danych do zewnętrznej usługi jest dopuszczalne. Oceń model na rzeczywistych danych i od początku zaprojektuj ścieżkę dla przypadków niepewnych.
Wybierz rozwiązanie lokalne, jeśli wymagania dotyczące prywatności, regulacji, rezydencji danych lub kontroli operacyjnej nie pozwalają na opuszczenie przez treść kontrolowanego środowiska.
Wybierz reguły lub dedykowany detektor PII, jeśli wymaganie jest wąskie, dobrze zdefiniowane i korzysta na przejrzystej logice wykrywania oraz anonimizacji.
Wybierz generatywny LLM, jeśli krok wymaga tworzenia treści, interpretacji szerszego kontekstu, wieloetapowego rozumowania albo obsługi przypadków, których nie da się opisać stabilnym zbiorem odpowiedzi.
Wybierz weryfikację przez człowieka, gdy niepewność jest istotna, konsekwencje błędu są wysokie albo odpowiedzialność za decyzję musi pozostać po stronie człowieka.
Porównanie nie powinno kończyć się na skuteczności modelu. Należy również ocenić prywatność, opóźnienie, całkowity koszt, trudność wdrożenia, utrzymanie, audytowalność, obsługiwane języki oraz koszt nieprawidłowej decyzji.
Najpierw projekt procesu, później wybór modelu
Najbardziej niezawodne systemy automatyzacji AI nie powstają przez umieszczenie jednego modelu przed każdym problemem. Punktem wyjścia jest mapa procesu: jakie decyzje są podejmowane, jakich informacji wymagają, co można zautomatyzować, a co powinno zostać eskalowane.
Jev wprowadza interesującą możliwość szybkiego podejmowania ustrukturyzowanych decyzji. Lokalny detektor może nadal być lepszą pierwszą warstwą kontroli dla danych wrażliwych. Generatywny LLM może okazać się niezbędny w dalszej części procesu. Tam, gdzie niepewność i konsekwencje są wysokie, potrzebna pozostaje ocena człowieka.
Właściwe pytanie nie brzmi „gdzie możemy wykorzystać LLM-a?”. Powinniśmy zapytać: jakiego rodzaju decyzji wymaga ten krok i które narzędzie zapewni odpowiednią równowagę jakości, prywatności, szybkości i kontroli?
W Inero właśnie w ten sposób podchodzimy do automatyzacji AI: zaczynamy od procesu i architektury, a każdy model dobieramy do konkretnej roli.
- Automatyzacja AI
- Jev AI
- LLM
- Wykrywanie PII
- AI Governance
- Lokalne modele AI
- Prywatność danych