6 min czytania
SMS MFA w Keycloak dla systemów z dużą liczbą użytkowników
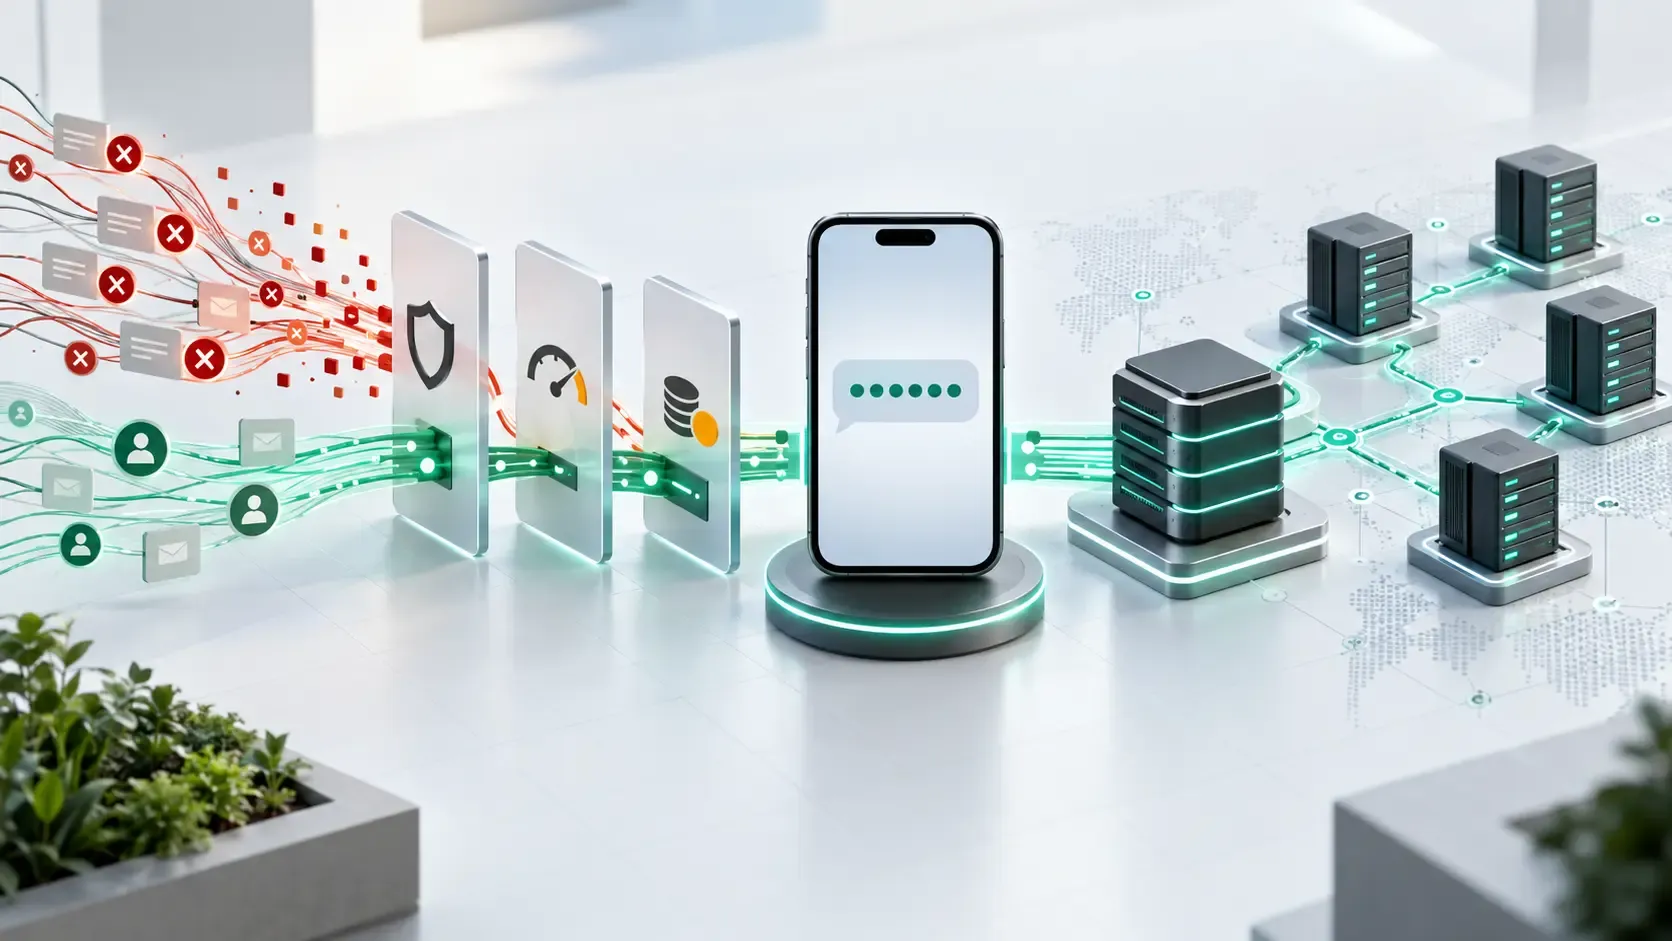
W niewielkim systemie wewnętrznym integracja SMS z Keycloak może być stosunkowo prosta: authenticator, połączenie z dostawcą wiadomości i podstawowa ochrona przed wielokrotną wysyłką. W dużym systemie publicznym ten sam mechanizm staje się częścią znacznie szerszego problemu bezpieczeństwa i utrzymania.
Pojawiają się równoległe żądania obsługiwane przez wiele instancji Keycloak, ataki rozłożone w czasie, zmieniające się źródła ruchu, różne profile ryzyka dla rejestracji i logowania oraz błędne blokady, które mogą dotknąć wielu prawidłowych użytkowników.
Ten artykuł rozwija temat niestandardowego uwierzytelniania SMS w Keycloak. Nie opisuje konfiguracji jednego środowiska ani gotowego zestawu progów. Pokazuje obszary, które warto przeanalizować przy projektowaniu SMS MFA działającego na dużą skalę.
SMS pumping: atak, którego celem nie musi być konto
W klasycznej analizie ryzyka MFA koncentrujemy się na przejęciu konta: brute force kodu OTP, phishingu, kradzieży sesji czy SIM swapie. Bramka SMS wprowadza jednak dodatkowe zagrożenie: SMS pumping, nazywany także SMS toll fraud lub Artificially Inflated Traffic.
Napastnik nie musi się zalogować. Wystarczy, że wykorzysta proces rejestracji, odzyskiwania dostępu lub wysyłki kolejnego kodu do generowania płatnych wiadomości. Pojedynczy SMS kosztuje niewiele, ale duży i długotrwały ruch może szybko stać się problemem z obszaru bezpieczeństwa, dostępności, finansów i obsługi klienta.
Dlatego skuteczności ochrony nie należy oceniać wyłącznie na podstawie liczby zablokowanych żądań. Ważne są również:
- tempo, w jakim może narastać koszt incydentu,
- maksymalny zasięg problemu,
- możliwość szybkiej reakcji operacyjnej,
- wpływ zabezpieczeń na prawidłowych użytkowników.
Nie zawsze da się zatrzymać każdy podejrzany request. Dobrze zaprojektowany system powinien jednak utrudniać automatyzację, ograniczać skutki nadużycia i dostarczać zespołowi dane potrzebne do reakcji.
Jedna reguła nie opisuje całego ryzyka
Prosty cooldown albo kontrola związana wyłącznie z numerem telefonu może być dobrym punktem wyjścia. Nie daje jednak pełnego obrazu sytuacji. Automatyczny ruch może korzystać z wielu numerów, kont, sesji i adresów IP, a także pozostawać poniżej pojedynczego progu przez dłuższy czas.
Projektując ochronę, warto patrzeć na kontekst żądania, a nie tylko na jeden licznik. Znaczenie mogą mieć między innymi:
- to, czy użytkownik i numer są już znane systemowi,
- źródło oraz powtarzalność ruchu,
- etap procesu uwierzytelniania,
- kierunek i koszt wysyłki,
- wcześniejsze poprawne i nieudane operacje,
- aktualna sytuacja w całej usłudze.
Nie oznacza to, że każdy z tych sygnałów powinien automatycznie blokować wiadomość. Część może jedynie podnosić poziom ryzyka, kierować żądanie do dodatkowej weryfikacji albo wpływać na decyzję podejmowaną w połączeniu z innymi informacjami.
Polityka powinna wynikać z rzeczywistego profilu ruchu organizacji. Zbyt łagodne zasady nie ograniczą kosztu ataku, a zbyt agresywne obniżą skuteczność rejestracji i logowania. Przy dużej liczbie użytkowników nawet niewielki odsetek błędnych blokad może przełożyć się na znaczący problem operacyjny.
Rejestracja i logowanie mają inne profile ryzyka
Z perspektywy integracji każda operacja może kończyć się wysłaniem kodu SMS. Z perspektywy ryzyka rejestracja, logowanie, zmiana numeru i odzyskiwanie konta są jednak różnymi procesami.
Podczas logowania system zwykle zna konto, powiązany numer i historię wcześniejszych uwierzytelnień. Przy rejestracji ma mniej kontekstu, a proces łatwiej zautomatyzować. Zmiana numeru dotyczy znanego użytkownika, ale wprowadza nowy identyfikator. Odzyskiwanie dostępu ma z kolei szczególnie duży wpływ na bezpieczeństwo konta.
Wspólna polityka dla wszystkich tych sytuacji upraszcza konfigurację, ale może być zbyt restrykcyjna dla jednych użytkowników i zbyt łagodna dla innych. Lepszym punktem wyjścia jest ocena ryzyka całego procesu: jakie dane są już zweryfikowane, jaki skutek ma wysłanie wiadomości i jakie dodatkowe sygnały są dostępne.
Ostrożności wymagają także wyjątki. Poprawne uwierzytelnienie jest wartościowym sygnałem, ale nie powinno automatycznie usuwać całej historii istotnej dla ochrony przed nadużyciem.
Zewnętrzna ocena ryzyka jako dodatkowa warstwa
Lokalny system dobrze zna reguły biznesowe i wcześniejsze zachowanie użytkownika, ale może mieć niewiele informacji o nowym numerze lub ruchu pochodzącym spoza organizacji. Taką ocenę mogą uzupełniać wyspecjalizowane usługi antyfraudowe.
Przykładem jest Google Cloud SMS Defense, które przed wysłaniem wiadomości zwraca ocenę ryzyka związanego z SMS toll fraud. Taki sygnał może wspierać decyzję, szczególnie gdy lokalna historia jest jeszcze ograniczona.
Zewnętrzna ocena nie powinna jednak być jedynym zabezpieczeniem. Usługa może być niedostępna, zwrócić błędną ocenę albo nie znać specyfiki danego procesu. Architektura musi więc określać zachowanie w przypadku braku odpowiedzi oraz rozdzielać odpowiedzialność między lokalne reguły, kontrolę kosztów i zewnętrzne źródła ryzyka.
Środowisko rozproszone zmienia sposób przechowywania stanu
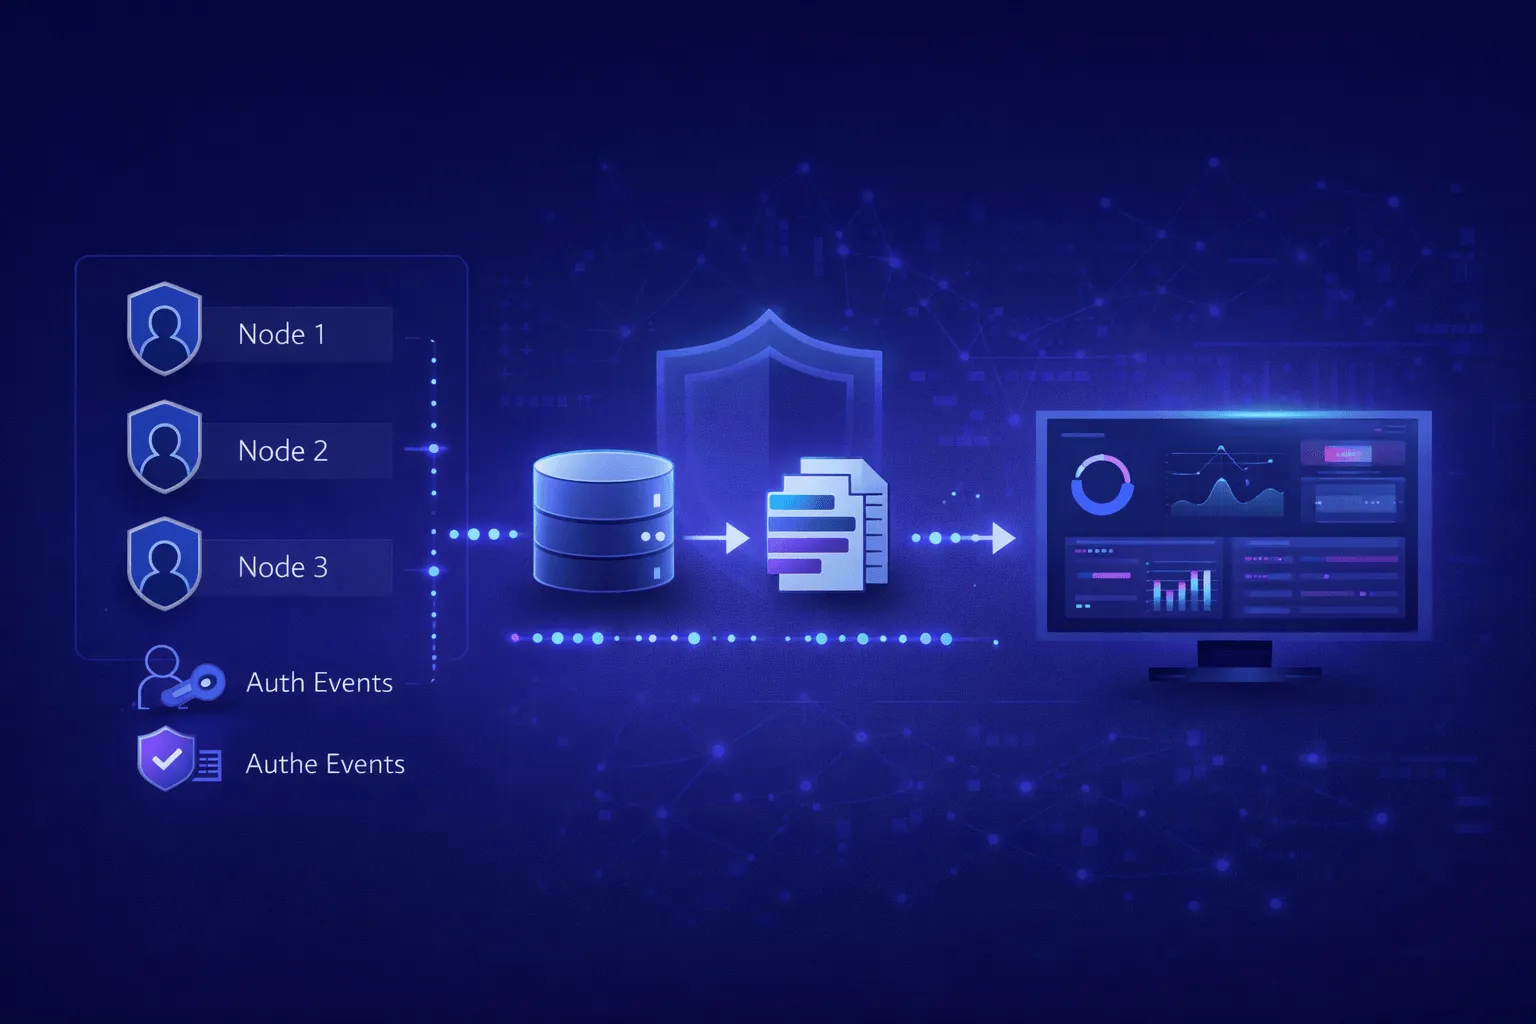
Keycloak często działa jako klaster wielu instancji. Mechanizm ochronny oparty wyłącznie na pamięci pojedynczego procesu nie widzi wtedy pełnego ruchu i może podejmować decyzje na podstawie niekompletnych danych.
Stan używany do oceny ryzyka powinien być dostępny tam, gdzie podejmowana jest decyzja, i zachowywać się przewidywalnie podczas równoległych żądań, restartów oraz zmian topologii klastra. Trzeba również zdecydować, które informacje są krótkotrwałe, a które powinny przetrwać dłużej.
Keycloak wykorzystuje Infinispan jako warstwę cache dla środowisk klastrowych. Dokumentacja Keycloak opisuje rozproszone cache’e używane m.in. dla sesji oraz wykrywania nieudanych logowań. Przy własnych rozszerzeniach można brać ten mechanizm pod uwagę, ale wybór magazynu stanu powinien zależeć od wymagań dotyczących trwałości, wielu regionów, awarii i wspieralności danej konfiguracji.
Osobnym problemem jest współbieżność. Gdy kilka żądań pojawia się niemal jednocześnie, niezależne sprawdzenie i późniejsza aktualizacja stanu mogą prowadzić do niespójnej decyzji. Operacje wpływające na możliwość wysłania wiadomości powinny być projektowane z uwzględnieniem atomowości, idempotentnych ponowień i niejednoznacznych odpowiedzi dostawcy SMS.
Polityka musi być konfigurowalna i operacyjna
Wartości sterujące ochroną nie powinny być zaszyte w kodzie. Ruch użytkowników, ceny dostawcy i zachowanie napastników zmieniają się szybciej niż cykl wydawania aplikacji.
Zespół techniczny powinien dostarczyć bezpieczne mechanizmy konfiguracji, wartości startowe i ograniczenia chroniące przed przypadkowo niebezpiecznym ustawieniem. Właściciel procesu, zespół bezpieczeństwa i zespół operacyjny powinni wspólnie oceniać zmiany na podstawie danych o ruchu oraz akceptowanego ryzyka.
Istotny jest także sposób wprowadzania zmian. Polityka powinna być możliwa do audytowania, testowania i szybkiego wycofania. W przeciwnym razie reakcja na incydent może sama spowodować problem z dostępnością usługi.
Obserwowalność: bezpieczeństwo, koszt i doświadczenie użytkownika
Mechanizmu ochronnego nie da się bezpiecznie stroić bez danych. Obserwacja powinna obejmować trzy perspektywy:
- bezpieczeństwo: zmiany wzorców ruchu i przyczyny odrzuceń,
- koszt: wolumen oraz wydatki w czasie i według kierunku wysyłki,
- doświadczenie użytkownika: skuteczność ukończenia procesu, opóźnienia i błędne blokady.
Metryki nie powinny zawierać numerów telefonów, pełnych adresów IP ani innych danych powodujących ryzyko prywatności lub niekontrolowaną kardynalność. Do analizy pojedynczych incydentów lepiej używać odpowiednio zabezpieczonych logów oraz identyfikatorów korelacyjnych.
Wzrost liczby odrzuceń może oznaczać atak, ale również błędną konfigurację, awarię dostawcy albo zmianę zachowania prawidłowych użytkowników. Dlatego alert powinien być początkiem analizy, a nie automatycznym potwierdzeniem fraudu.
Najważniejsze wnioski
SMS MFA w dużym systemie nie jest wyłącznie funkcją authenticatora. To proces, który łączy bezpieczeństwo konta, kontrolę kosztu, niezawodność środowiska rozproszonego i doświadczenie użytkownika.
Najważniejsze zasady są następujące:
- Oceniaj kontekst całego procesu, a nie tylko pojedynczy numer lub request.
- Rozróżniaj ryzyko rejestracji, logowania, zmiany numeru i odzyskiwania konta.
- Traktuj zewnętrzną ocenę fraudu jako dodatkowy sygnał, a nie jedyne źródło decyzji.
- Projektuj stan oraz współbieżność z myślą o klastrze Keycloak.
- Strojenie opieraj jednocześnie na danych o bezpieczeństwie, kosztach i zachowaniu prawidłowych użytkowników.
Najtrudniejszym elementem nie jest zbudowanie możliwie restrykcyjnej ochrony. Jest nim ograniczanie nadużyć w sposób praktycznie niewidoczny dla osób prawidłowo korzystających z systemu.
Jeżeli planujesz wdrożenie lub audyt produkcyjnego środowiska IAM, porozmawiaj z zespołem INERO zajmującym się Keycloak. Możemy pomóc ocenić architekturę MFA, ryzyka operacyjne i sposób utrzymania dopasowany do Twojego środowiska.
- cyberbezpieczeństwo
- Fraud Detection
- IAM
- Keycloak
- MFA
- SMS
- SMS MFA